OSCAR: O(1)-Step Convergence And Readily-deployable Congestion Control 论文阅读
Introduction
CC 收敛速度十分重要,现如今 DCN 内带宽越来越高,并且在模型训练中普遍存在 On-Off 形态流量,这些服务都需要快速收敛。
借用大
- 基于精确 INT 信息:通过精确 INT 信息进行 MIMD 调速,需要网络硬件支持较长的 INT 信息处理,但处理 INT 信息会损失吞吐量
- 接收端驱动:基于接收端发送的 credit 来调整速率,需要配置完善且对称的数据中心拓扑结构,但过度订阅和链路故障会破坏这一前提,一些接收端驱动的 CC 还依赖包裁剪、优先队列或对称路由能力
- 交换机驱动:使用交换机管理网络状态,主动引导发送端调整速率,需要交换机有计算能力,但商用交换机几乎没有
本文提出了这样的问题:一个可部署的 CC 是否能实现
本文贡献如下:
- 两条设计原则
- 对精确信号做 MIMD 反应是必要的
- 只要解决了其内在约束(即瓶颈队列既非空也非满,且对于延迟,所有流均受窗口限制;对于延迟梯度,所有流均受速率限制)问题,延迟和延迟梯度便可作为精确的拥塞信号,从而实现
步收敛
- 解决实现上面设计原则遇到的问题及解决方案
- 高速网络下低开销高精度计算延迟梯度:BLS 算法
- 过度响应:基于与拥塞信号同步的发送状态(而非当前发送状态)更新
- 延迟和延迟梯度控制不同目标,可能互相影响:设计了能够同时实现这两个控制环路目标的控制律
- 模拟和实际实现
注意:如无特殊说明,本文中的「收敛」指达到目标状态(如满利用率或短队列),而非收敛至公平。收敛至目标状态指实现高吞吐和低延迟。
Motivation
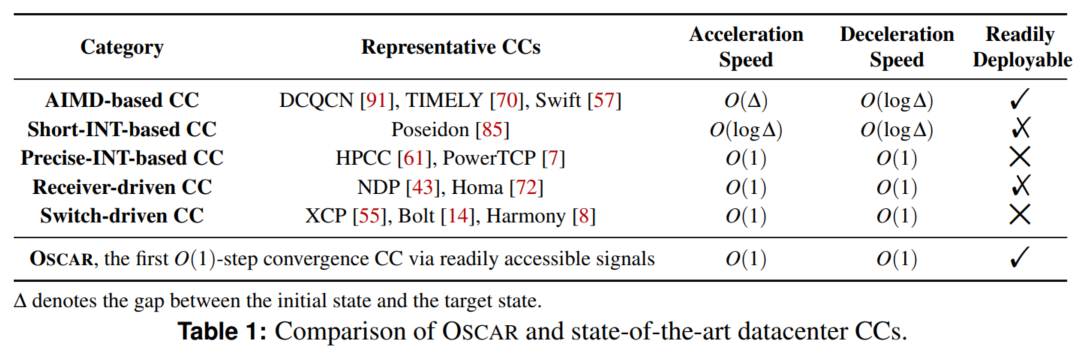
首先文章总结了现有的 CC。
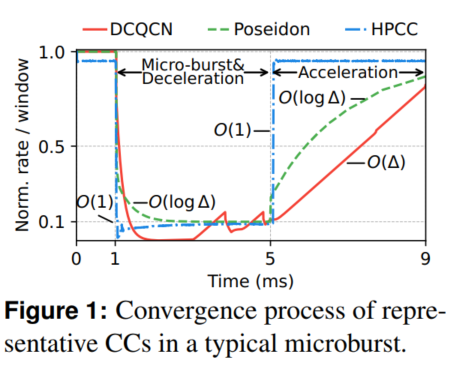
然后做了一些预实验,上图展示了在由九条于 1 毫秒至 5
毫秒期间保持活跃的短寿命流量诱发的典型微突发场景中,三种具有代表性的 CC
条件下长寿命流量的收敛情况。
对于 AIMD-based
CC,在加速过程中,它们以固定步长增速,因此从当前速率增到目标速率的 gap
也可以看 ECN or Delay 中的分析,已经证明了是对数收敛的
对于 Short-INT-based CC(也就是 Poseidon),它使用紧凑的 INT 头携带每跳延迟,并采用一种在较低速率下加速更快的控制律,从而在加速和减速过程中均能实现对数复杂度收敛。
对于 Precise-INT-based CC,使用 MIMD 算法在
但是
这个 INT prepending 看起来是类似 SRv6 塞栈那么搞,但不太确定。
其次对于接收端驱动的 CC,它们依赖包喷洒来避免核心层拥塞,这要求数据中心拓扑结构配置合理且对称,但是现代数据中心是有 oversubscription 的,并且时常有链路故障,导致对称拓扑具有挑战性;并且包喷洒可能有乱序问题,最新的网卡(CX-8)完整支持这个特性,但以前的网卡只对部分 verbs 提供有限支持;最后一些接收端驱动的方案需要网络支持包裁剪、优先队列或者对称路由,这都降低了可部署性。
最后是交换机驱动的 CC,它完全依赖交换机具有计算能力,也难以部署。
Design Rationale
原则 1
首先做了一些实验,通过实验测量了 HPCC 在 10:1 incast
场景中的长流有效吞吐量和利用率
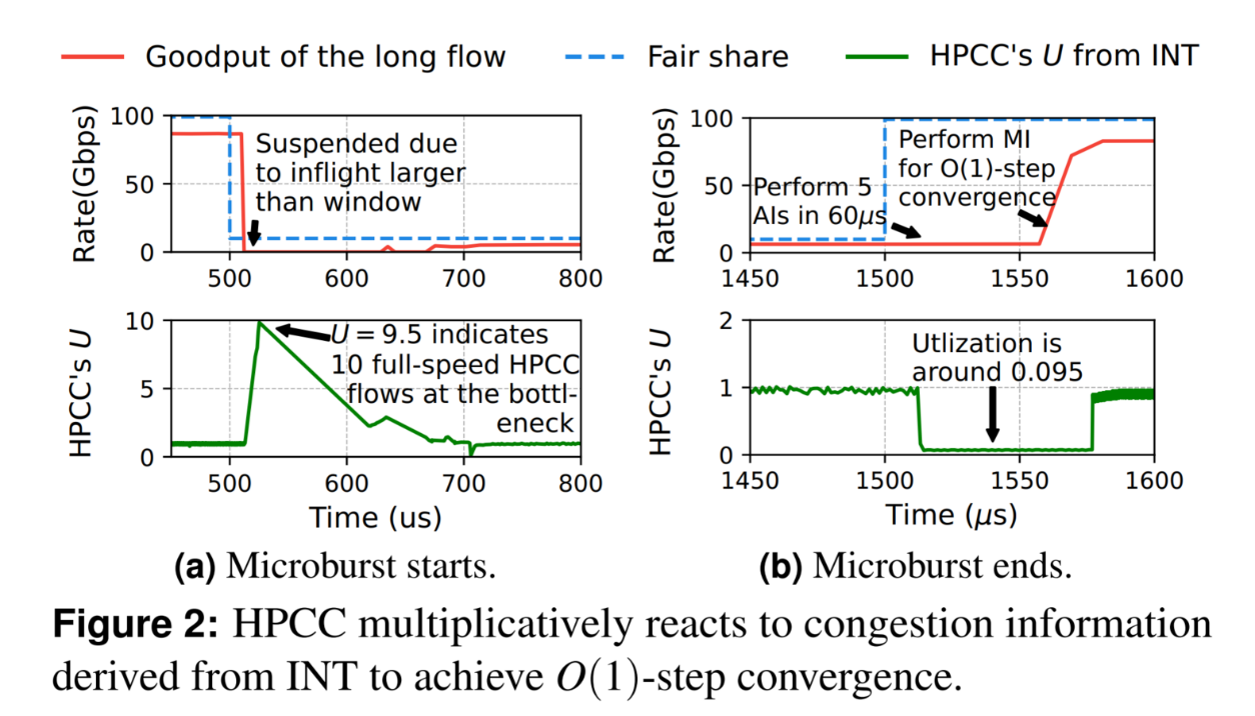
如上图,实验显示拥塞信号
反之考虑加性反馈。考虑某流在时刻
相反,一次 MI 可表达为
总结上述观察,可以总结出原则 1:CC 应该对精确的拥塞信号乘性反应来达到
原则 2
考虑容易获得的多 bit 拥塞信号(如延迟或延迟梯度)是否能实现精确拥塞信号(INT)的精度。
先看延迟,令
考虑单瓶颈,则有
假设队列非空(这样
这里如果队列是空的,等式右侧可能为负数(也可能为 0),所以这个等式不再普遍成立。
由于
由于
认为
成立,这里我们暂且不考虑速率的事。
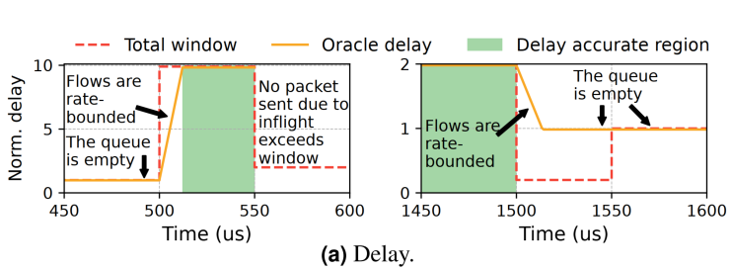
为了检验这一理论,实现了一个 oracle CC,该模型通过同时控制窗口和速率,使瓶颈处的队列达到一个 BDP 的目标值,并且总能在一步内收敛到目标值,反应延迟为 50 µs。图中展示微突发开始和结束时,以基准 RTT 归一化的延迟以及以基准 BDP 归一化的总窗口。
在微突发开始时,延迟在约 10 µs 内增加到
图中 550 µs 时窗口掉了,而且 oracle delay 没了,是因为缩减窗口后 inflight 仍然大于窗口,所以没有继续发包,并不是队列炸了。看的是 500-550 时间区间的情况。
所以可以总结观察 2.1:延迟精确反映了在「队列既非空也非满」且「所有流量受窗口限制」的约束条件下,通过瓶颈的流量的总窗口大小。
再看延迟梯度,令
我也不懂为啥写了这么长,其实利用上面
直接对时间微分就是了。
现在考虑一个极小时间片
代入上面公式,积分微分相消,则有
实际上上面那个积分又微分并不严谨:
并不是「积分之后就没了」,真正省略的是 的极限过程,按理说应该用定义给一个比较严谨的证明。 由于队列守恒,有 则 而 在 邻域连续,那么区间平均值趋近于瞬时值 因此
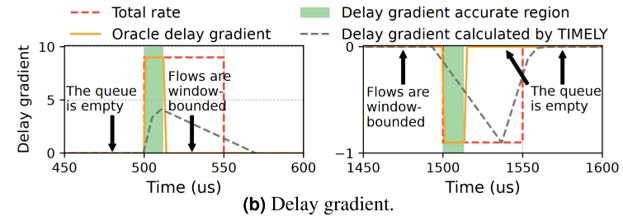
仍然通过 oracle CC 检验,并对比 TIMELY 计算的延迟梯度。上图中展示了微突发开始和结束时的延迟梯度及归一化总速率,其中 oracle 延迟梯度通过滑动窗口最小二乘法(SWLS)计算得出。
在拥塞开始时(500 µs-510 µs),预言机延迟梯度上升至
9,准确反映了瓶颈处的到达率(
所以可以总结观察 2.2:延迟梯度精确反映了在「队列既非空也非满」且「所有流量受速率限制」的约束条件下,通过瓶颈的流量的总速率大小。
观察 TIMELY 的行为,在微突发期间,由 TIMELY 计算出的延迟梯度计算精度较低,且对微突发结束的响应存在滞后。由此可以得到观察 2.3:精确计算延迟梯度是有挑战性的。
根据上述观察可以得出原则 2:CC 可以利用延迟和延迟梯度作为精确的拥塞信号,但同时也需要克服其固有的局限性——即这些信号仅在特定条件下才能作为精确信号,且难以测量。
根据这些推导,可以得出一些方案。假设目标队列长度为
Design
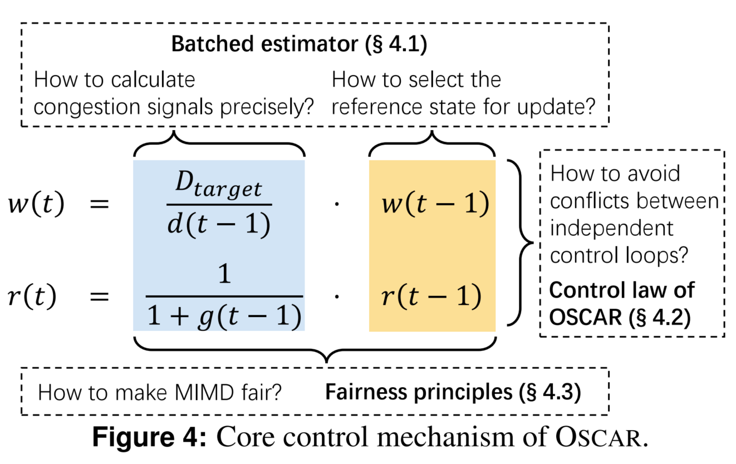
数据来源
方案用到延迟和延迟梯度,都需要测量。
延迟没什么好说的,直接往包头部塞个时间戳就是了。
对于测量延迟梯度,简单的方法是将延迟差除以数据包发送时间戳的差值,然后应用噪声平滑算法来减小误差。 但是现在包之间的发送间隔很短(~10ns),进行除法时,小分母可能显著放大延迟的误差,此外,EWMA 可能会削弱或延迟对拥塞信息的感知,正如 TIMELY 算法一样。
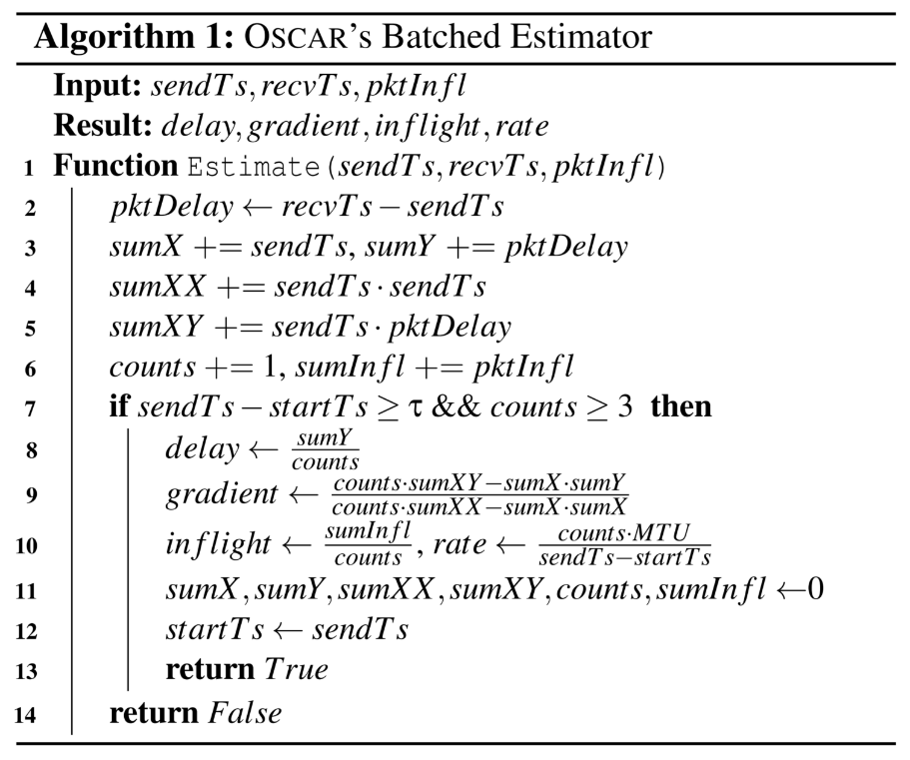
考虑将测量的 (发送时间, 延迟) 看做平面上的一个点,那么可以用这些点拟合一条回归直线,这条直线的斜率就是延迟梯度。
令
这个想法十分人类智慧,但是十分合理。
实现中只有收到不少于三个 ACK 才会计算回归直线,使用时还有一个更新周期
参考状态选取
MIMD 更新中,为了避免波动和过度反应,选择正确的参考状态很重要。HPCC
每 RTT 更新一次参考窗口
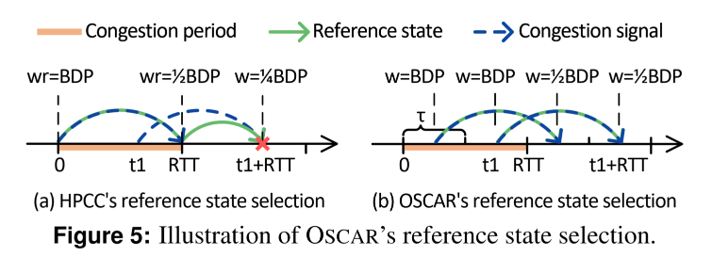
考虑两个窗口大小都为 BDP 的流争夺同一瓶颈,拥塞从时刻 0
开始,持续一个 RTT。在拥塞发生后一个 RTT,HPCC 接收到来自时刻 0
的拥塞信号,并使用该时刻的窗口大小更新
OSCAR 使用与拥塞信号同步的状态作为更新时的参考状态。在
那么就产生了一个问题:如何在 pktInfl 包含在报头中,收到 ACK 后,批量估算器将
pktInfl 累加到 sumInfl 中。计算实际 inflight
为 sumInfl / counts,发送速率为
counts·MTU / (sendTs−startTs),其中 MTU
表示最大传输单元,sendTs-startTs 是估算周期的长度。
把 inflight 传出去看起来略幽默但确有道理,莫名想到了 jwt。
OSCAR 可与 ACK 合并机制配合使用。
控制律设计
控制律设计问题在于如何协调两个控制环。
首先有如下定理:当在 CC 中同时使用窗口和速率时,只有当窗口和速率分别与目标窗口和目标速率保持相同的比率时,才可能收敛。证明在附录。
定义统一窗口比为流的窗口大小比目标窗口,即
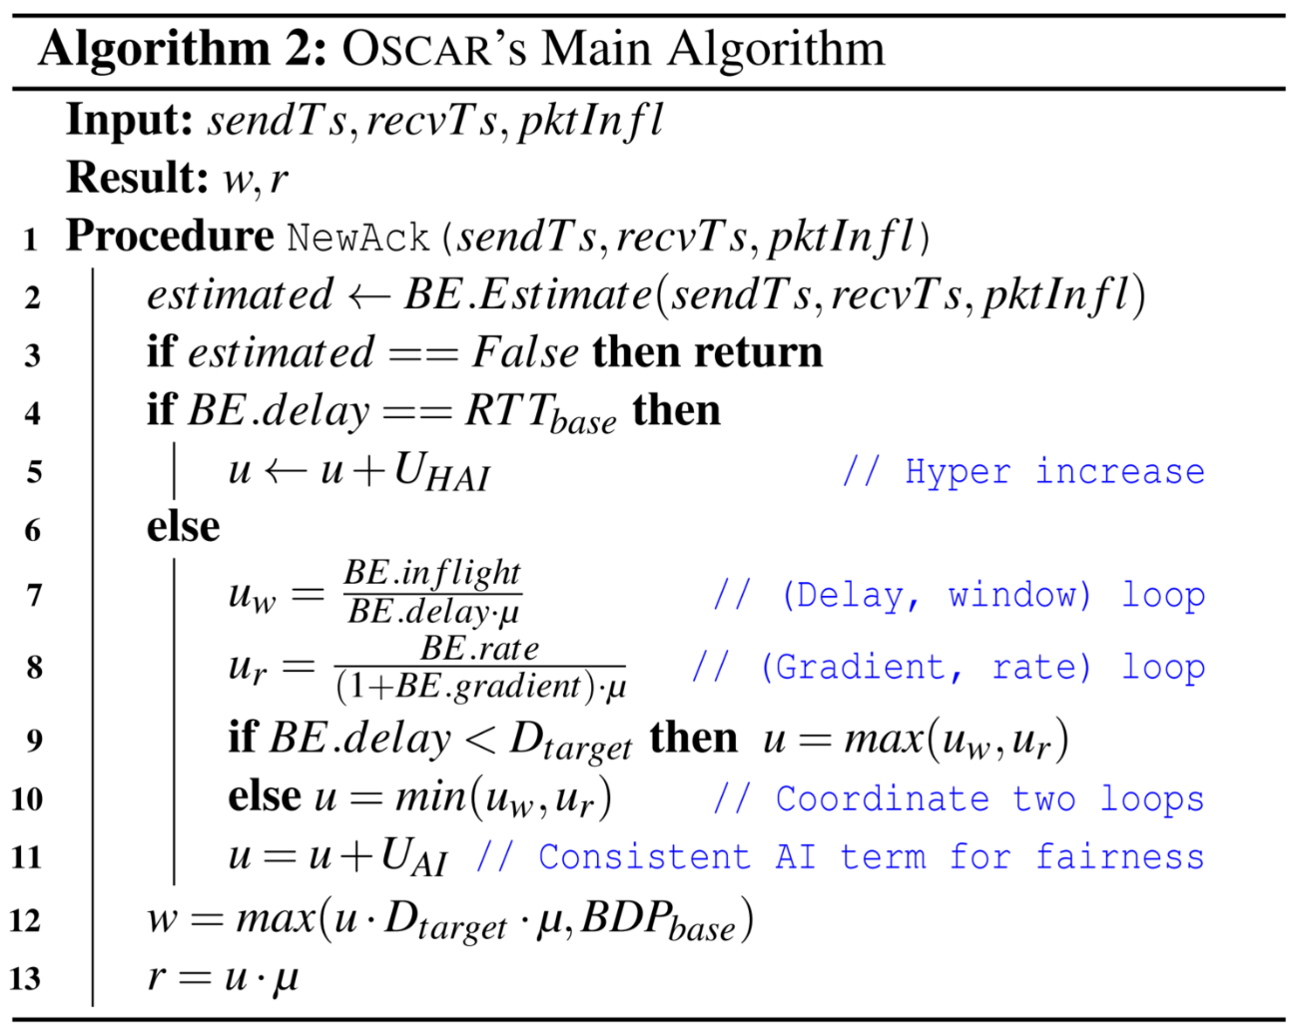
注意,原论文 Algorithm 2 第 12 行写的是
,但紧邻正文称 OSCAR「不会把窗口设置到基准 BDP 以上」。如果以正文描述的窗口上限为准,这里应该使用 ,因此疑似是原论文的笔误。
现在要协调两个控制环,会发现不可能同时满足两个控制环的目标。比如,如果当入速率等于线速时,队列长度稳定但大于目标值,那么 [延迟, 窗口] 控制环会建议减速,而 [延迟梯度, 速率] 控制环则会建议保持当前速率。因此优先考虑 [延迟, 窗口] 循环的目标,即把队列长度稳定在目标队列长度,这是因为如果将目标设定为让瓶颈的入速率和线速相等,可能会导致队列长度收敛到任意值(包括过高值),但这是不可取的。因此,当观测到的延迟低于目标值时应该加速,反之减速。
另一个观察是在瓶颈队列既非空也非满时,延迟和延迟梯度的不准确性仅会导致信号数值减小,回顾观察
2.1 和 2.2,当流量不受窗口限制时,延迟小于
再考虑面对空队列和满队列。发送端探测延迟是否近似等于
公平性
发现在论文假设各流同步进行更新的模型下,遵循如下原则就能确保基于 MIMD 的 CC 的公平性:
- MIMD 操作对其自身状态呈线性关系
- 每次 MIMD 操作之后都执行一次 AI 操作
可直观理解为:
- MI 先用于收敛
- 收敛后,随后的 AI 会略微超额占用带宽,从而触发 MD 重新建立收敛
- 由于 CC 总是先执行 MD 再执行 AI,因此该过程将不断重复
- 收敛后,CC 便进入 AIMD 循环,从而在上述同步流模型下确保公平性
综合方案设计如下图。
设计讨论
相较于基于精确 INT 信息的 CC:
- 无需很长的 INT 头
- 避免 MIMD 控制中由过度反应引起的震荡
- HPCC 通常每 5 个 RTT 执行一次 MI,OSCAR 不会产生过度反应,且在上述同步流模型下能确保公平性,因此能够更频繁地执行 MI,从而提高对资源利用不足问题的响应能力
相较于 θ-PowerTCP:
- θ-PowerTCP 同样使用延迟和延迟梯度,但仅能实现
步收敛 - θ-PowerTCP 的核心缺陷在于其设计前提,在网络利用率不足时,延迟信号无法精确反映网络状态,这导致该算法在此类场景下只能使用 AI
- 与这一前提相反,我们的分析表明精确反映是可行的,OSCAR
充分利用了这种精确性,实现了
步收敛
可以与逐包负载均衡兼容:
- DCQCN 对单路径拥塞信号过于敏感,这可能会导致资源利用率不足
- HPCC 的 txRate 计算依赖于同一端口发出的连续 INT,而逐包负载均衡恰恰违反了这一先决条件
- 但 BLS 汇总固定时间段内的拥塞信息,这能够让 OSCAR
避免对单一路径的拥塞反应过度,即使在链路故障等事件发生时,也能保持快速的
步收敛
参数
:高 有利于吞吐敏感流量,低 有利延迟敏感流量,设置为 :BLS 和 OSCAR 更新的时间间隔,设置为 :经过敏感性实验设置为 0.01 :公平性参数,建议设置为 0.001
Discussion
除了后面所说的 max-min 公平性感觉已经把 DCN 内的 CC 做完了。但是这个公平性有用吗?我倒是一直不怎么 care 公平性。
相较于 PowerTCP,可解释性更好了,不需要引入所谓的电流电压了,很好理解。
实现,测试和后面附录部分已经看力竭了,摇了我罢小伙汁。